

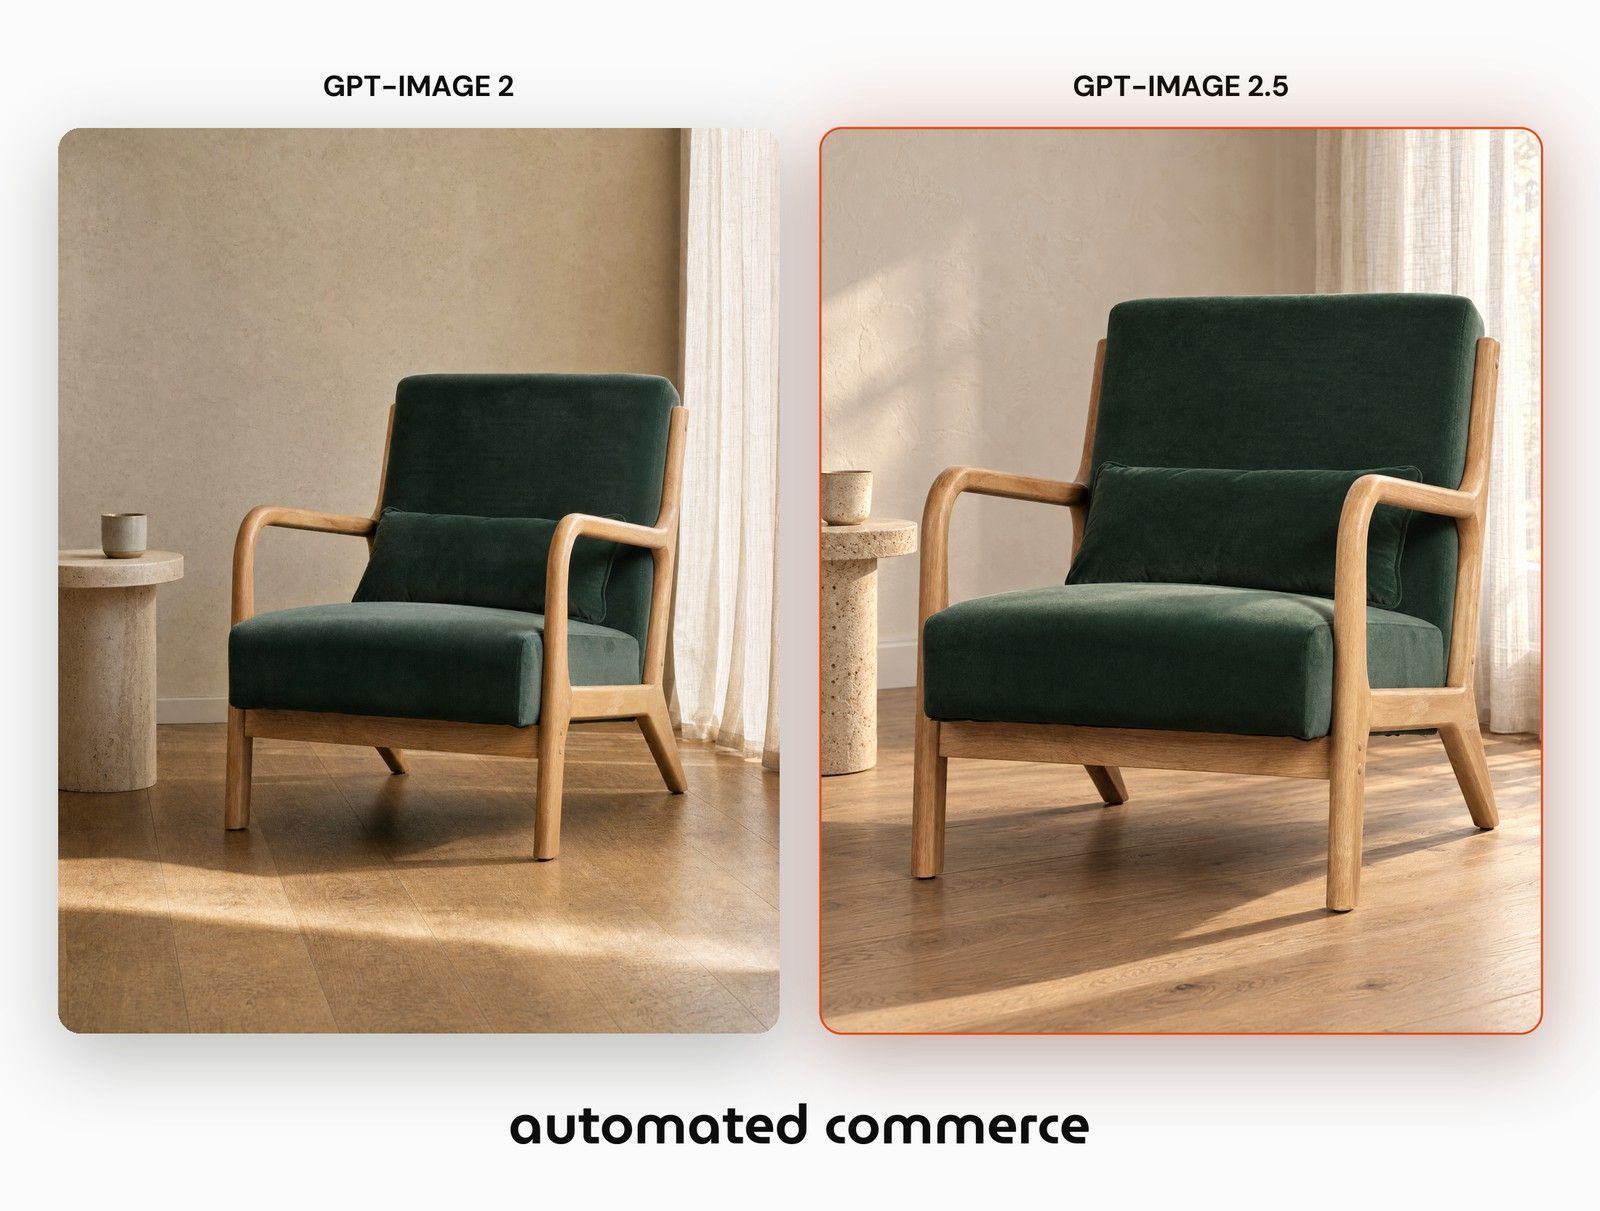
OpenAI heeft deze maand GPT Image 2.5 uitgebracht, in twee varianten. Het interessante zit niet in dat het er beter uitziet. Het zit erin dat het een kwart kost van wat GPT Image 2 voor dezelfde klus kost, en dat verandert wat je je kunt veroorloven over een hele catalogus in plaats van over je twintig best lopende producten.
We hebben beide modellen tegen elkaar gezet op vier echte retailcatalogi: een meubelpackshot, een fashionset, een studiobeeld uit herenmode en een woonproduct. Zelfde inputbestand, zelfde prompt, vier keer gedraaid per model, allebei op hun hoogste kwaliteitsstand. Dit kwam eruit.
Wat OpenAI heeft uitgebracht
GPT Image 2.5 komt in twee modellen, en dat verschil bepaalt hoe je werk routeert.
Sunburst is de precieze variant. Meer detail op fijn werk, in ruil voor een tragere render. Dit is het model voor een afgebakende opdracht: vervang het model in dit beeld, laat de set met rust.
Flare is de standaard. Snel, hoge kwaliteit, natuurlijk licht en rijke textuur. Dit is het model voor volumewerk waar de briefing open is in plaats van chirurgisch.
Beide gaan tot 3840x2160 en beide kosten 8 credits per beeld in Automated Commerce, tegenover 31 credits voor GPT Image 2 op hetzelfde formaat en dezelfde kwaliteitsstand. Op ruwe providerkosten is dat USD 0,053 tegen USD 0,220 per beeld.
Waarom de prijsdaling zwaarder weegt dan de kwaliteitssprong
Een kwaliteitsverbetering die je in één beeld ziet is een mooie demo. Een kostendaling van 75 procent is een operationele beslissing.
Neem een catalogus van 400 producten. Vier keer draaien per product, zodat je iets te kiezen hebt, kost 49.600 credits op GPT Image 2 en 12.800 op GPT Image 2.5. Hetzelfde budget dat eerst 100 producten dekte, dekt nu de hele catalogus.
Elke golf in retailtooling heeft dit moment gehad. Productfeeds waren specialistenwerk tot ze dat niet meer waren. Mobiele optimalisatie was een project tot het de standaard werd. De verschuiving zit nooit in de feature. Hij zit op het punt waarop de kosten ver genoeg dalen dat je het niet langer rantsoeneert voor je hero-producten.
Wat we hebben gemeten
Een model dat goed oogt in één beeld is niet hetzelfde als een model dat vier van de vier keer de briefing volgt. Dus we hebben gehoorzaamheid gemeten, geen schoonheid.
De meubeltest gaf beide modellen dezelfde kaderinstructie, afgeleid uit een meting van de eigen lifestylefotografie van het merk: zet de fauteuil zo in beeld dat hij ongeveer driekwart van de breedte vult. De eigen foto van het merk zit op 0,73. GPT Image 2 kwam uit op 0,56 tot 0,59 over vier draws. GPT Image 2.5 kwam uit op 0,76 tot 0,81.
De fashiontest vroeg beide modellen om de persoon in een afgemaakt setbeeld te vervangen en de walnoten wandpanelen erachter met rust te laten. Die wand heeft strakke verticale nerf en harde paneelnaden, dus hij heeft een signatuur die je kunt correleren met het originele bestand. GPT Image 2 scoorde 0,87 tot 0,91. GPT Image 2.5 scoorde 0,93 tot 0,95. De ranges overlappen niet. GPT Image 2 schilderde de set stilletjes opnieuw terwijl het het model verving.
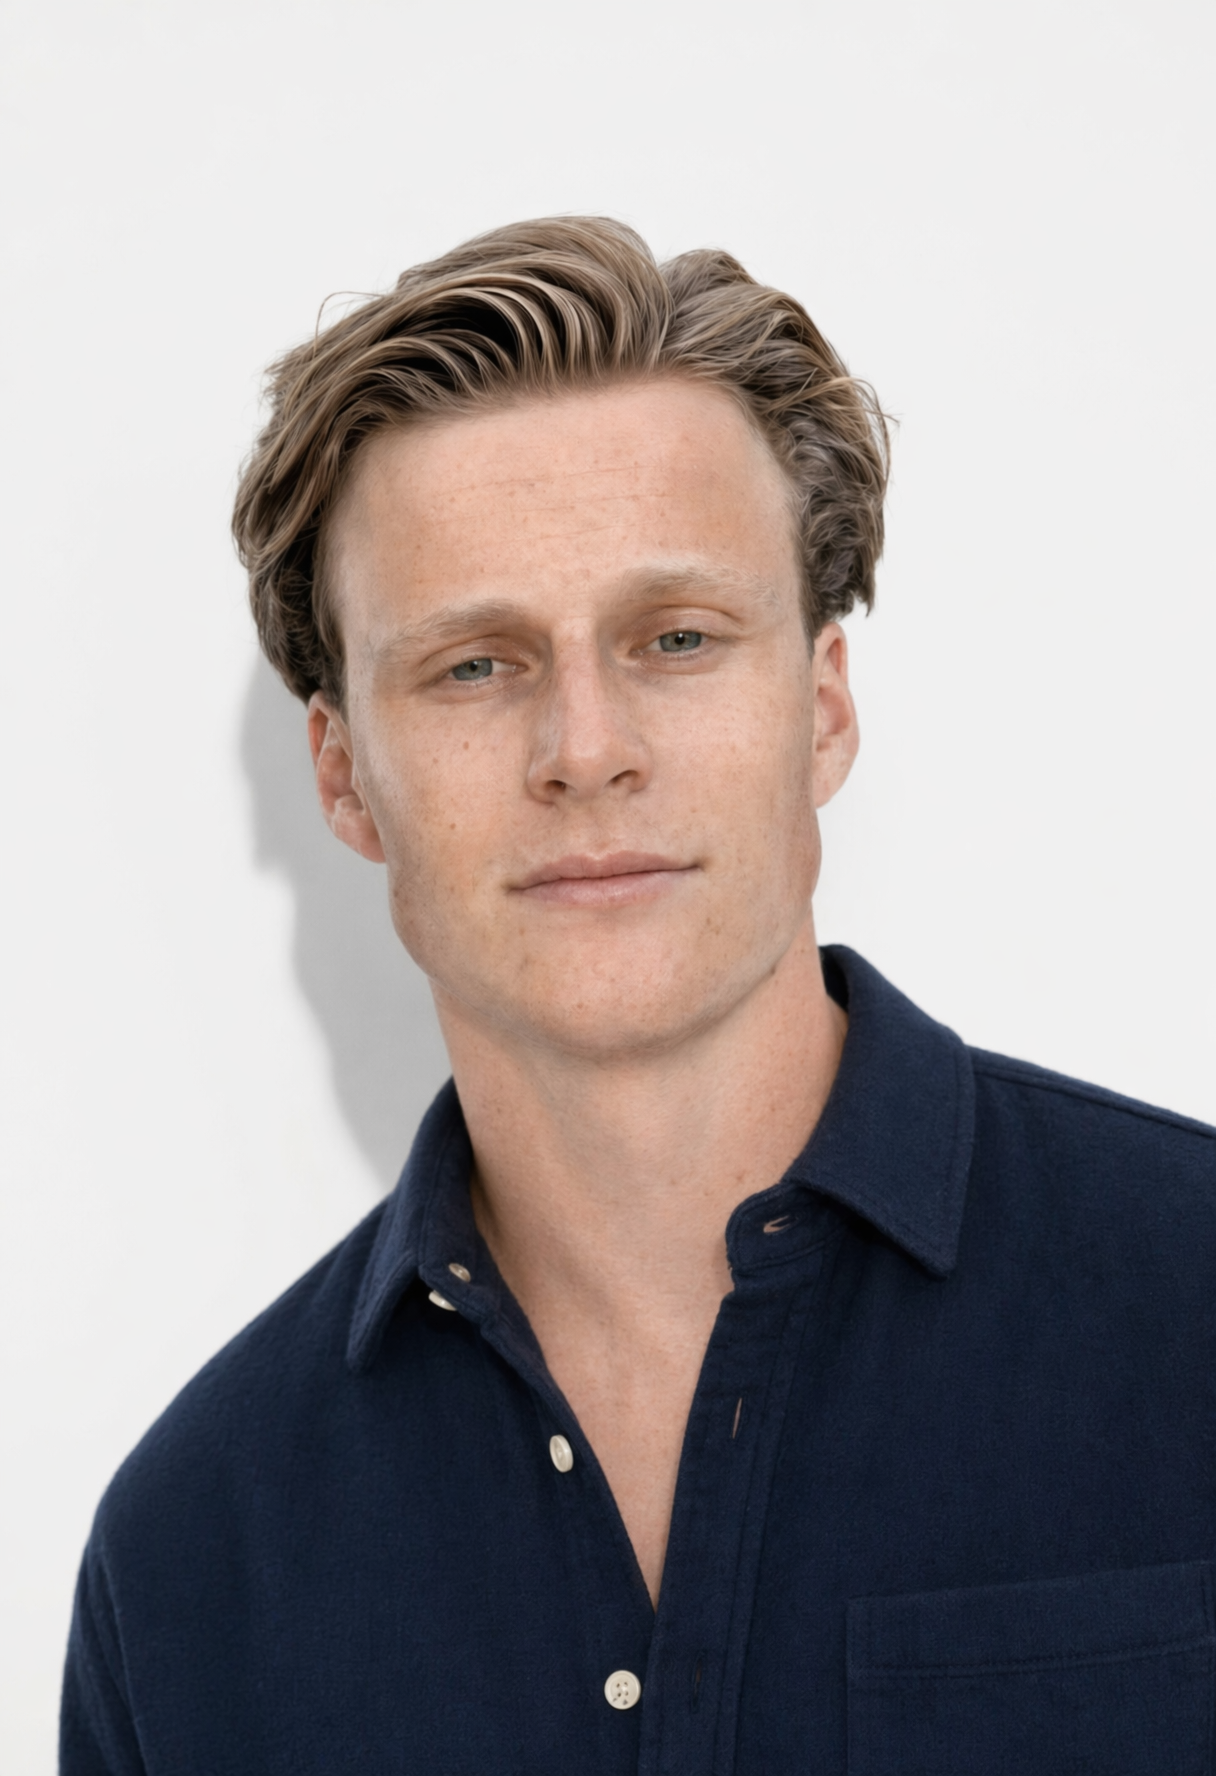
De herenmodetest leek gelijkspel tot we de kadering maten. Drie van de vier draws van GPT Image 2 hielden het beeld vast. De vierde zette de camera terug en leverde een figuur ten voeten uit op 60 procent van de gevraagde breedte. Alle vier de draws van GPT Image 2.5 zaten binnen een band van 0,016.
Die vierde draw is het echte risico in catalogus werk. Eén beeld op de vier dat je product stilletjes anders kadert ziet er niet uit als een fout. Het ziet eruit als variatie, tot er vierhonderd van live staan.
Waar GPT Image 2.5 verliest
Op het woonproduct hield GPT Image 2 het merkgrijs vrijwel exact vast, een kleurafwijking van 1,1 tegenover de packshot. GPT Image 2.5 maakte het warmer, tot 4,9. Een deel daarvan is natuurkunde, want een warme kamer maakt het ding dat erin staat warmer. Een deel is drift.
Als kleur is wat jouw merk beschermt, is dat een echte kostenpost en hoort hij in de vergelijking. GPT Image 2.5 won diezelfde test op materiaal: de fleece bies bleef een gekrulde lus in plaats van af te vlakken tot een koord, de melange spikkel overleefde, en het licht had richting.
Een vergelijking met alleen winstpunten is reclame. Het verlies is wat de rest van de cijfers vertrouwen geeft.
Hoe je een model kiest zonder te gokken
De methode telt zwaarder dan de winnaar van deze week, want volgende maand ligt er weer een nieuw model.
Draai hetzelfde inputbestand door beide modellen. Geef beide dezelfde prompt, hetzelfde uitvoerformaat en de hoogste kwaliteitsstand van elk model, zodat de kostenregel eerlijk blijft. Neem vier draws per model, geen één, want één draw zegt niets over consistentie. Meet de uitkomst daarna tegen de eigen fotografie van het merk, niet tegen je eigen smaak.
Dit is precies het probleem waar Automated Commerce omheen gebouwd is. Productbeeld is catalogusdata, en catalogusdata moet bij het vierhonderdste item net zo goed kloppen als bij het eerste.
Wat je nu kunt doen
De praktische bescherming is structureel. Als je beeldgeneratie in een workflow zit, is je catalogus verhuizen naar een nieuw model één wissel op één plek.
Drie dingen die de moeite waard zijn in de week dat een model landt:
- Benchmark het tegen het model dat je vandaag draait, op je eigen producten, niet op de demobeelden van de leverancier.
- Routeer per use case, want infographics, mensen en productconsistentie zijn drie verschillende klussen en hebben zelden dezelfde winnaar.
- Houd generatie modulair, zodat een modelwissel een instelling is in plaats van vierhonderd herschreven prompts.
Beide varianten van GPT Image 2.5 draaien vanaf vandaag in Automated Commerce. Hoe zou jij deze week weten of het model dat jouw productbeeld maakt nog steeds het juiste is?